
キャッシュは、再び使う可能性が高いデータなどを近くに置き、取り出す時間を減らす仕組みです。この記事ではCPUのキャッシュメモリを中心に、ヒット・ミス・局所性を整理します。
基本の意味をつかんだ後、ヒット率とアクセス時間を使う計算は、最後の無料noteで例題に進めます。
1.CPUと主記憶の速度差を補う
CPUが主記憶からのデータを待つ時間を減らすために、小容量で高速なキャッシュメモリを使います。よく使う資料を本棚から机の上へ出しておくイメージです。
2.ヒットとミスを分ける
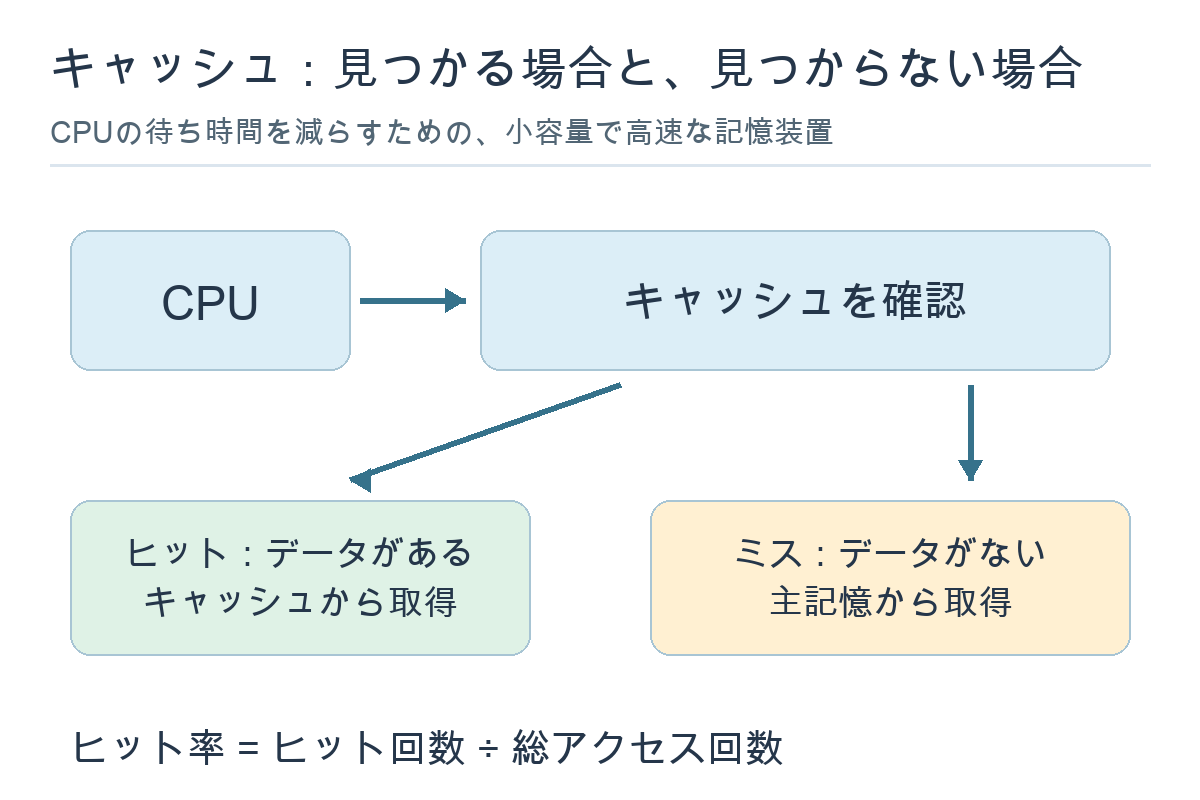
| 状態 | 意味 | データ取得先の基本 |
|---|---|---|
| ヒット | 必要なデータがキャッシュにある | キャッシュ |
| ミス | 必要なデータがキャッシュにない | 主記憶など下位の記憶階層 |
100回のアクセスで90回ヒットなら、ヒット率は90÷100=0.9、百分率では90%です。ミス率はこの例で10%。割合を使う計算では90ではなく0.9に直す必要があります。
3.局所性がキャッシュを有効にする
時間的局所性は、最近使ったデータを再び使う傾向です。空間的局所性は、アクセスした場所の近くのデータも使う傾向です。同じ変数の繰返しや、配列の連続アクセスをイメージしましょう。
4.階層とWebキャッシュの違い
一般的にはL1 → L2 → L3 → 主記憶のような階層があります。CPUに近い階層ほど高速・小容量になる傾向がありますが、実装はCPUにより異なります。ブラウザのキャッシュも再利用のための保存ですが、CPUキャッシュとは保存対象や仕組みが異なります。
理解を確かめる確認問題
キャッシュメモリを利用する主な目的はどれでしょうか。
ア:主記憶容量を増やす イ:データを圧縮する ウ:CPUと主記憶の速度差を補う エ:通信速度を上げる
解答・解説を見る
正解はウです。必要なデータを高速に取り出し、CPUの待ち時間を減らします。
まとめ:ヒットとミスでは、かかる時間が違う
ヒット率が高いほど、速い記憶階層からデータを取り出せる機会が増えます。次は割合と各アクセス時間から、平均の時間を求める練習へ進めます。

コメント